素材从哪里来?
将参考视频拆成框架、人物、场景、故事与承接关系。人工收集链接、审核结果,AI 承担结构化拆解。
PRODUCT CONTENT / 打品方法论
以狂奔公司牛倩团队的 AI 视频提效项目为例,展示素材如何入库、产品卖点如何匹配人群与场景,以及框架如何扩展成多产品线脚本。
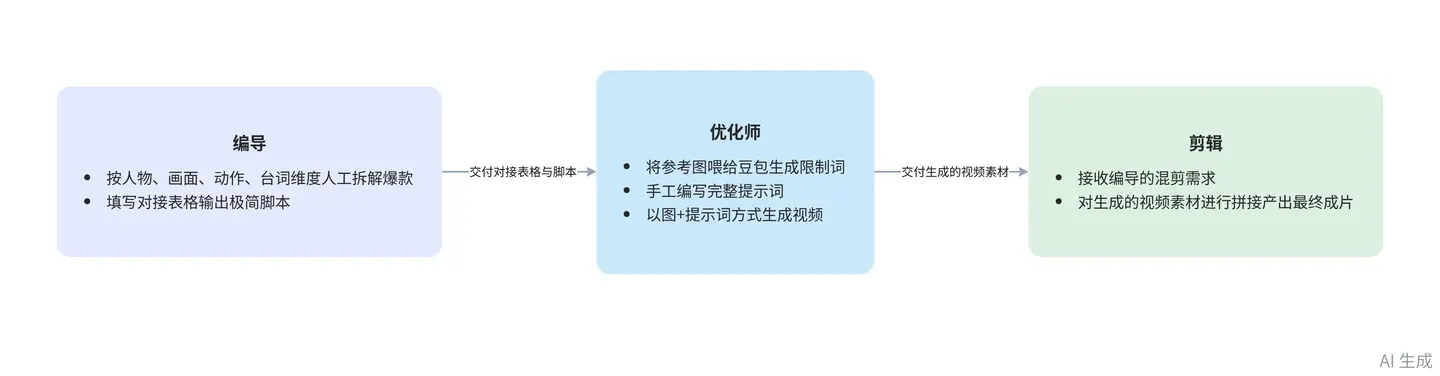 改造前的通用 AI 视频生产链路
将参考视频拆成框架、人物、场景、故事与承接关系。人工收集链接、审核结果,AI 承担结构化拆解。
明确本品主卖点与需求时刻,提取可视化证据,再索引对应的人物、场景与故事素材。
保留框架与购买理由,替换产品、人物关系和场景,说明每个片段的用途与衔接。
视频拆解:从编导人工拆解,转为 AI 拆解与人工审核。
脚本合成:从编导手工制作,转为单个 Skill 批量组装。
编导人工拆解人物、画面、动作与台词,输出简要脚本;优化师根据参考图和镜头时序手工编写提示词;生成视频后再交给剪辑。信息传递依赖表格与口头沟通,修改往往需要反复往返。
先收集成熟参考,再让 AI 按字段拆解,由人工审核修正。判断规则、提示词与已确认案例沉淀下来,供后续产品分析和脚本制作复用。
| 资产层 | 保留什么 | 如何使用 |
|---|---|---|
| 框架与承接 | 内容片段的功能、顺序与衔接 | 复用结构,保留购买理由 |
| 人物、场景与故事 | 关系、动作、环境、触发事件与因果链 | 按本品人群和需求时刻检索 |
| 产品与证据 | 主次卖点、适用条件、证据画面、限制表达 | 约束脚本中的产品事实 |
| 结果与版本 | 来源记录、元素 ID、测试结果与修订规则 | 回指来源,保留有效组合 |
先记录看见和听见的事实,再整理框架与人物关系。将事实、合理推断、产品主张和创意延展分开,避免把参考视频中的表达直接当成本品证据。
| 拆解层 | 关键记录 | 交付用途 |
|---|---|---|
| 逐秒与镜头 | 时间码、原始文案、景别、角度、运镜、主体动作、切镜和声音连续性 | 还原片段范围与镜头承接 |
| 人物与需求 | 出镜人物、目标人群、使用人、买单人、关系、触发条件、具体任务、期望结果 | 区分谁出镜与谁购买 |
| 场景与故事 | 地点子区域、前中背景、道具、光线、生活痕迹、触发、行动、冲突与产品进入 | 支撑场景复现与故事迁移 |
| 卖点与证据 | 痛点、卖点、证明对象、证据等级、适用条件与禁用表达 | 建立需求到证据的对应链 |
| 迁移与入库 | 保留项、替换项、唯一元素 ID、来源记录与标签 | 让素材可检索、可追溯、可复用 |
过程指标用于定位问题,投放与转化用于检查业务结果。跨表汇总时对齐快照日期、采集时间与统计周期,不将不同业务线或不同产出环节混为一谈。
| 数据来源 | 跟踪维度 | 对应判断 |
|---|---|---|
| 千川投放后台 | 消耗金额、素材消耗排名、投放 ROI、转化 | 对比消耗 Top10 与垫底各 10 组素材,筛选值得拆解的参考 |
| 投放侧过程指标 | 前 3 秒留存、完播率、点赞量、评论内容 | 判断开头吸引力,并用评论补充需求线索 |
| 对标作品数据表 | 点赞、评论、转发、收藏、弹幕及新增量;互动率、时长、发布时间与采集时间 | 保留表现上下文,发现选题与表达方式 |
| 产品分析主表 | 已验证卖点数、候选卖点数、证据画面数、素材数、配方 / 资质数、痛点 / 价值数、分析状态 | 跟踪产品知识沉淀与分析完成度 |
| 产品分析明细 | 适用人群、场景、证据描述、景别、动作、声音 / 触感、推荐及禁用表达、合规等级、优先级 | 为脚本检索与分镜制作提供可调用字段 |
| 生产运营 | 单人日均产出、抽卡率、每周模板数、素材成本(元 / 秒) | 分别衡量拆解、脚本与视频生产效率及成本 |
文档提及作品表已采集 66 条作品。本页展示实际跟踪维度与判断机制;未提供完整周期数据的 ROI、留存率等不补填数值。
读取本品资料、已确认卖点、适用人群、需求时刻和可用证据。
兼容实际表头,核对来源视频与记录;只有句式时,不补写所谓原始完整框架。
选择剧情、句式、硬广等片段,说明功能、顺序和承接,再匹配人像、场景与声音。
标明保留、改编与新生成部分,审核产品事实和制作条件,结果回流到规则库。
完整视频由多个可独立调用、替换或改编的内容片段组成。框架规定它们的顺序、作用与衔接;不同片段可以采用用户、商家、达人或旁白视角,不必强行讲成同一个故事。
内容依据《狂奔公司 AI 视频生成提效案例——牛倩团队关键成果梳理》整理。资料由会议纪要、过程截图及客户补充反馈组成;其中“需求时刻先行”等部分执行规则为后续补充,不作为已验证会议结论。